---
title: "Resultados"
---

```{r}
#| label: setup-resultados
#| include: false
library(dplyr)
library(tidyr)
library(ggplot2)
library(knitr)

load("input/datos_igualdad_oportunidades.RData")

# Paleta divergente: grises para el desacuerdo, rojos para el acuerdo
pal_p19 <- c("Muy en desacuerdo" = "#4A4A4A", "En desacuerdo" = "#BDBDBD",
             "De acuerdo"        = "#E06A55", "Muy de acuerdo" = "#99000D")
cats <- names(pal_p19)

# Formato de números en español
f1 <- function(x, d = 1) formatC(x, format = "f", digits = d, decimal.mark = ",", big.mark = ".")

y <- datos_io |>
  filter(!is.na(p1_9_ord)) |>
  mutate(ola_lab = factor(ola, 1:2, c("Ola 1 (2023-2024)", "Ola 2 (2024)")),
         cohorte = factor(cohorte_media, 0:1, c("B\u00e1sica", "Media")))

# Distribución por ola
dist_ola <- y |>
  count(ola, p1_9_ord) |>
  group_by(ola) |>
  mutate(pct = 100 * n / sum(n)) |>
  ungroup()
pct <- function(o, cat) dist_ola$pct[dist_ola$ola == o & dist_ola$p1_9_ord == cat]

# Porcentaje de acuerdo (de acuerdo + muy de acuerdo)
acu <- y |> group_by(ola) |> summarise(a = 100 * mean(p1_9 >= 3), n = n())
acu_c <- y |> group_by(ola, cohorte) |> summarise(a = 100 * mean(p1_9 >= 3), .groups = "drop")
ac <- function(o, c = NULL) if (is.null(c)) acu$a[acu$ola == o] else acu_c$a[acu_c$ola == o & acu_c$cohorte == c]
dist_c <- y |> count(ola, cohorte, p1_9_ord) |> group_by(ola, cohorte) |> mutate(pct = 100 * n / sum(n)) |> ungroup()
pc <- function(o, c, cat) dist_c$pct[dist_c$ola == o & dist_c$cohorte == c & dist_c$p1_9_ord == cat]

# Cambio dentro de los estudiantes que responden ambas olas
w <- datos_io |>
  select(id_estudiante, ola, p1_9) |>
  pivot_wider(names_from = ola, values_from = p1_9, names_prefix = "o") |>
  filter(!is.na(o1), !is.na(o2))
cambio <- c(igual = 100 * mean(w$o1 == w$o2), sube = 100 * mean(w$o2 > w$o1), baja = 100 * mean(w$o2 < w$o1))
cruza  <- 100 * mean((w$o1 >= 3) != (w$o2 >= 3))
wt <- wilcox.test(w$o2, w$o1, paired = TRUE, exact = FALSE)
```

## Análisis descriptivo

### Percepción de igualdad de oportunidades

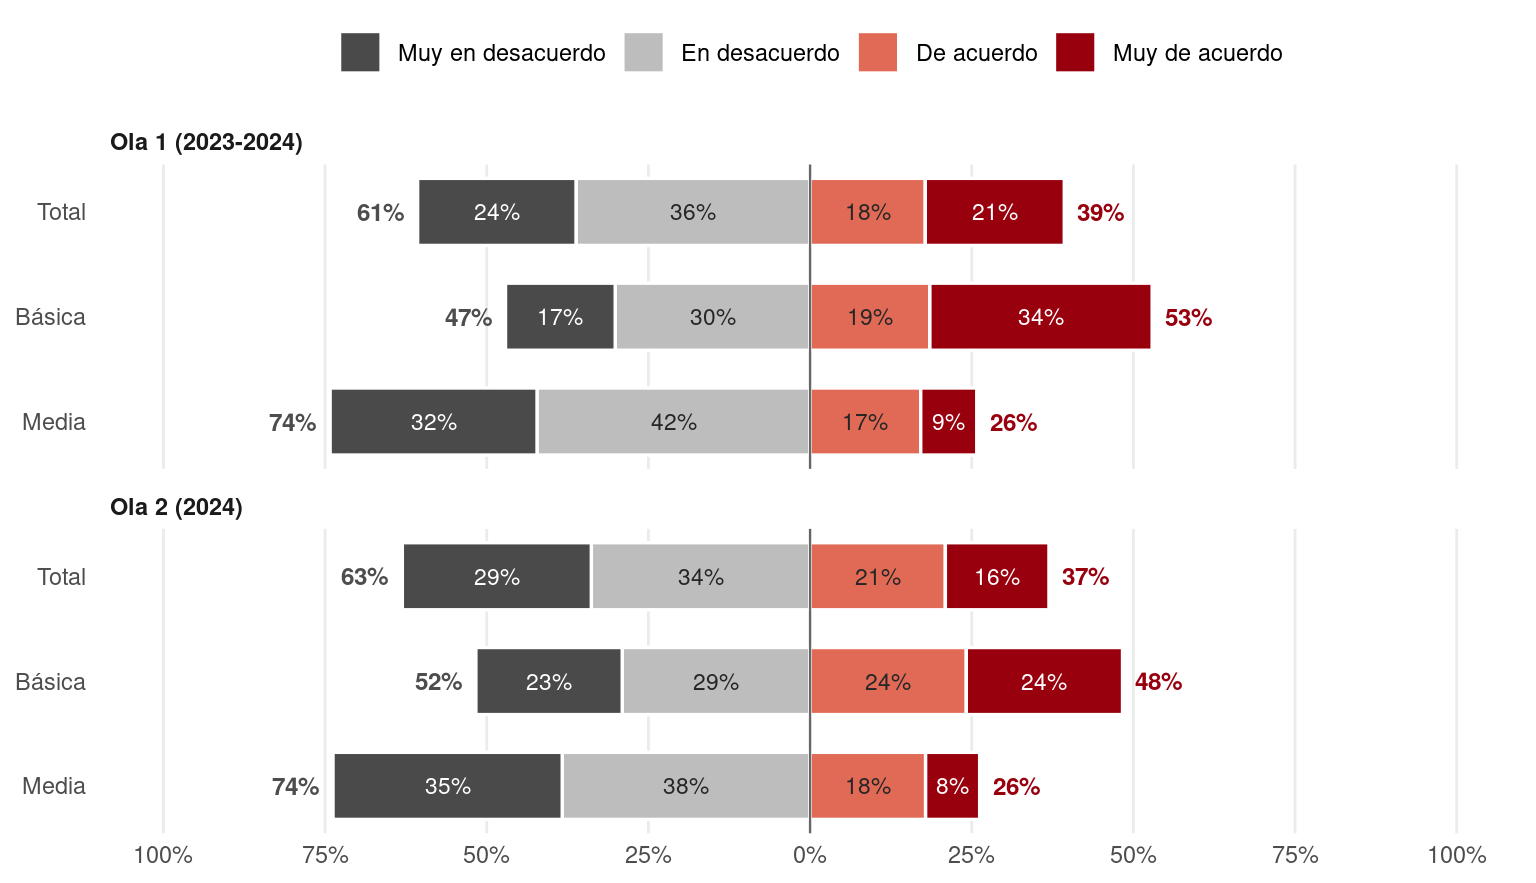
Como la variable dependiente es un ítem ordinal de cuatro categorías, se describe mediante su distribución completa y no mediante un promedio. La @tbl-p19-ola presenta la distribución por ola y la @fig-p19-distribucion la desagrega por cohorte.

En la primera ola, el `r f1(ac(1))`% de los estudiantes está de acuerdo o muy de acuerdo con que en Chile todas las personas tienen las mismas oportunidades para salir adelante, mientras que el `r f1(100 - ac(1))`% está en desacuerdo o muy en desacuerdo. La categoría más frecuente es "en desacuerdo" (`r f1(pct(1, "En desacuerdo"))`%), que corresponde también a la mediana. La percepción de igualdad de oportunidades es, por tanto, minoritaria entre los estudiantes, aunque no marginal: cerca de cuatro de cada diez la sostienen.

```{r}
#| label: tbl-p19-ola
#| tbl-cap: "Percepción de igualdad de oportunidades según ola. Frecuencias y porcentajes."
#| echo: false
tab <- dist_ola |>
  mutate(v = paste0(n, " (", f1(pct), "%)")) |>
  select(p1_9_ord, ola, v) |>
  pivot_wider(names_from = ola, values_from = v) |>
  mutate(p1_9_ord = as.character(p1_9_ord))
tab <- bind_rows(tab, tibble(p1_9_ord = "Total",
                             `1` = as.character(acu$n[acu$ola == 1]),
                             `2` = as.character(acu$n[acu$ola == 2])))
kable(tab, col.names = c("En Chile, todas las personas tienen las mismas oportunidades para salir adelante", "Ola 1", "Ola 2"),
      align = c("l", "r", "r"))
```

Las diferencias entre cohortes son marcadas. En la primera ola, el `r f1(ac(1, "B\u00e1sica"))`% de los estudiantes de básica está de acuerdo o muy de acuerdo, frente al `r f1(ac(1, "Media"))`% de los de media. En básica, la categoría más frecuente es "muy de acuerdo" (`r f1(pc(1, "B\u00e1sica", "Muy de acuerdo"))`%), mientras que en media solo el `r f1(pc(1, "Media", "Muy de acuerdo"))`% elige esa opción y el `r f1(pc(1, "Media", "Muy en desacuerdo") + pc(1, "Media", "En desacuerdo"))`% se ubica en el desacuerdo. La brecha se mantiene en la segunda ola (`r f1(ac(2, "B\u00e1sica"))`% y `r f1(ac(2, "Media"))`% de acuerdo, respectivamente). Este patrón es consistente con el marco más crítico que se ha observado entre los estudiantes de media al evaluar si el esfuerzo es recompensado [@laffert_changes], aunque la comparación entre cohortes debe interpretarse con cautela, porque contrasta a grupos distintos de estudiantes y no el cambio de los mismos estudiantes a lo largo del tiempo.

```{r}
#| label: fig-p19-distribucion
#| fig-cap: "Percepción de igualdad de oportunidades según ola y cohorte. Porcentajes; a la izquierda, desacuerdo; a la derecha, acuerdo."
#| echo: false
#| fig-width: 8
#| fig-height: 4.6
g <- bind_rows(y |> mutate(grupo = "Total"), y |> mutate(grupo = as.character(cohorte))) |>
  count(ola_lab, grupo, p1_9_ord) |>
  group_by(ola_lab, grupo) |>
  mutate(pct = 100 * n / sum(n)) |>
  ungroup() |>
  select(-n) |>
  pivot_wider(names_from = p1_9_ord, values_from = pct, values_fill = 0) |>
  mutate(grupo = factor(grupo, c("Media", "B\u00e1sica", "Total")), yy = as.numeric(grupo))

# Segmentos: el desacuerdo se apila hacia la izquierda y el acuerdo hacia la derecha desde el cero
segs <- bind_rows(
  g |> transmute(ola_lab, grupo, yy, cat = "En desacuerdo",     xmin = -`En desacuerdo`, xmax = 0),
  g |> transmute(ola_lab, grupo, yy, cat = "Muy en desacuerdo", xmin = -`En desacuerdo` - `Muy en desacuerdo`, xmax = -`En desacuerdo`),
  g |> transmute(ola_lab, grupo, yy, cat = "De acuerdo",        xmin = 0, xmax = `De acuerdo`),
  g |> transmute(ola_lab, grupo, yy, cat = "Muy de acuerdo",    xmin = `De acuerdo`, xmax = `De acuerdo` + `Muy de acuerdo`)
) |>
  mutate(cat = factor(cat, cats), x = (xmin + xmax) / 2, w = xmax - xmin,
         txt = ifelse(cat %in% c("Muy en desacuerdo", "Muy de acuerdo"), "white", "grey15"))

tot <- g |> transmute(ola_lab, yy,
                      des = `Muy en desacuerdo` + `En desacuerdo`,
                      acu = `De acuerdo` + `Muy de acuerdo`)

ggplot(segs) +
  geom_rect(aes(xmin = xmin, xmax = xmax, ymin = yy - 0.32, ymax = yy + 0.32, fill = cat),
            colour = "white", linewidth = 0.6) +
  geom_text(data = filter(segs, w >= 5), aes(x = x, y = yy, label = paste0(f1(w, 0), "%"), colour = txt),
            size = 3) +
  geom_text(data = tot, aes(x = -des - 2, y = yy, label = paste0(f1(des, 0), "%")),
            hjust = 1, size = 3.2, fontface = "bold", colour = "grey30") +
  geom_text(data = tot, aes(x = acu + 2, y = yy, label = paste0(f1(acu, 0), "%")),
            hjust = 0, size = 3.2, fontface = "bold", colour = "#99000D") +
  geom_vline(xintercept = 0, colour = "grey40", linewidth = 0.4) +
  facet_wrap(~ ola_lab, ncol = 1) +
  scale_fill_manual(values = pal_p19, breaks = cats, name = NULL) +
  scale_colour_identity() +
  scale_x_continuous(limits = c(-100, 100), breaks = seq(-100, 100, 25),
                     labels = function(x) paste0(abs(x), "%")) +
  scale_y_continuous(breaks = 1:3, labels = c("Media", "B\u00e1sica", "Total")) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 11) +
  theme(legend.position = "top",
        panel.grid.major.y = element_blank(),
        panel.grid.minor = element_blank(),
        panel.grid.major.x = element_line(colour = "grey92"),
        strip.text = element_text(face = "bold", hjust = 0))
```

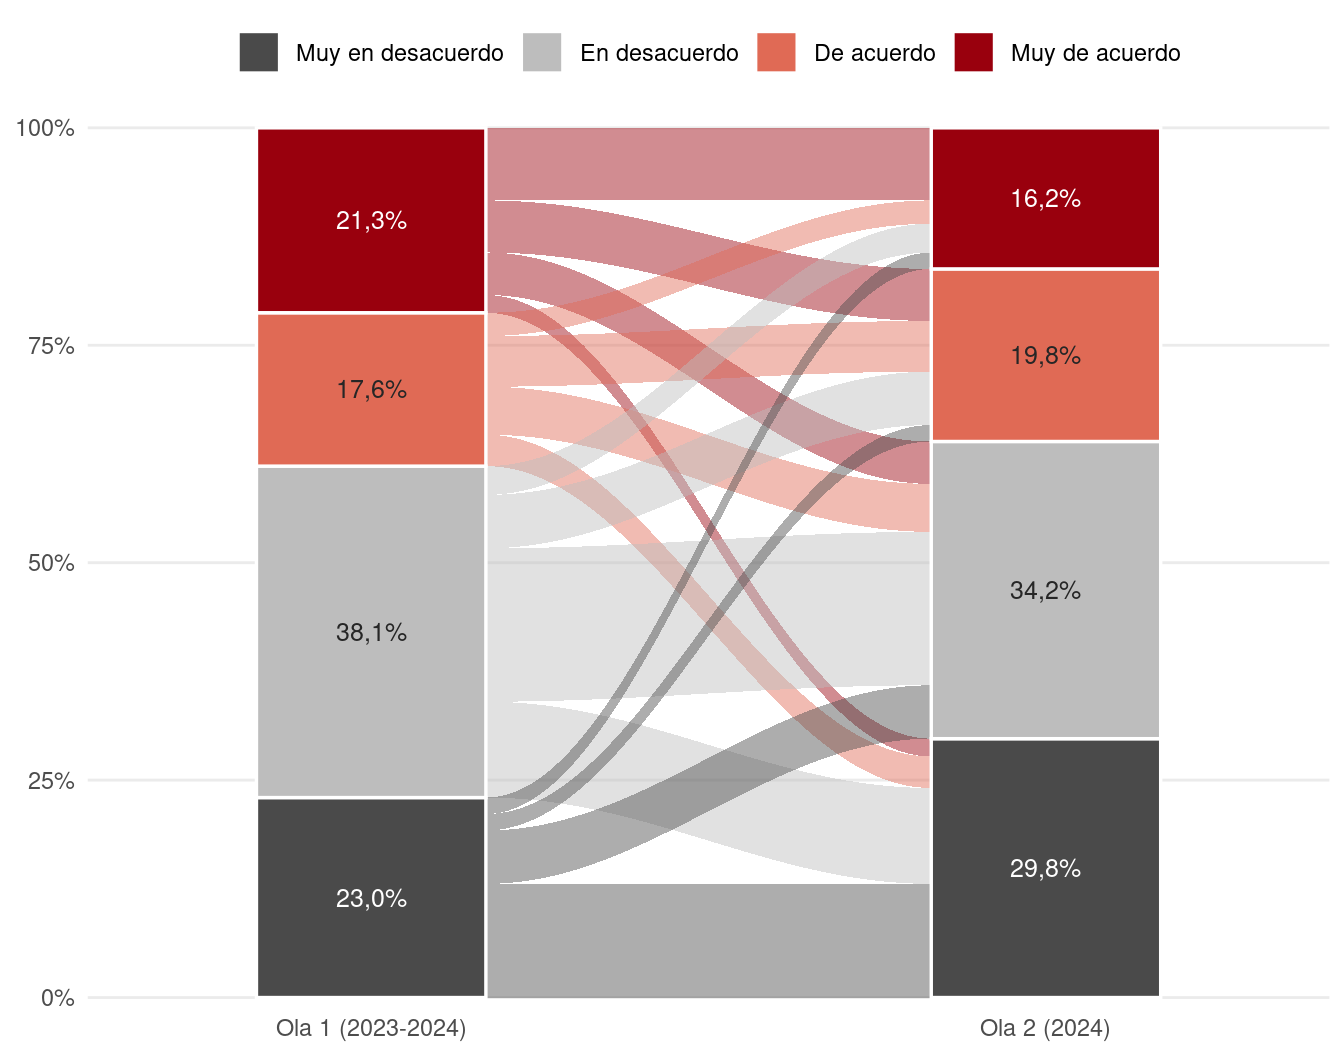
Entre olas, la percepción de igualdad de oportunidades tiende a disminuir. El porcentaje de acuerdo pasa de `r f1(ac(1))`% a `r f1(ac(2))`%, y la proporción que está muy en desacuerdo aumenta de `r f1(pct(1, "Muy en desacuerdo"))`% a `r f1(pct(2, "Muy en desacuerdo"))`%. Como la composición de ambas olas difiere por la atrición, el cambio se evalúa con los `r nrow(w)` estudiantes que responden en las dos mediciones (@fig-p19-transiciones). De ellos, el `r f1(cambio["igual"])`% mantiene la misma respuesta, el `r f1(cambio["baja"])`% se desplaza hacia el desacuerdo y el `r f1(cambio["sube"])`% hacia el acuerdo. La percepción es además relativamente inestable a nivel individual: el `r f1(cruza)`% de los estudiantes cambia de lado entre el acuerdo y el desacuerdo de una ola a otra. Este descenso es consistente con la hipótesis de ilustración (H5), que se evalúa formalmente en los modelos multivariados.

```{r}
#| label: fig-p19-transiciones
#| fig-cap: "Transiciones en la percepción de igualdad de oportunidades entre la ola 1 y la ola 2. Estudiantes que responden ambas olas; porcentajes sobre el total de esos estudiantes. Los flujos tienen el color de la respuesta en la ola 1."
#| echo: false
#| fig-width: 7
#| fig-height: 5.5
bw <- 0.34                               # ancho de las barras
x1 <- 1 + bw / 2; x2 <- 2 - bw / 2       # extremos de los flujos

# Flujos: cada combinación (respuesta ola 1 -> respuesta ola 2), apilada dentro de cada barra
fl <- w |>
  count(o1 = as.numeric(o1), o2 = as.numeric(o2)) |>
  mutate(p = 100 * n / sum(n)) |>
  arrange(o1, o2) |> mutate(y1max = cumsum(p), y1min = y1max - p) |>
  arrange(o2, o1) |> mutate(y2max = cumsum(p), y2min = y2max - p)

tt <- seq(0, 1, length.out = 60)
s  <- (1 - cos(pi * tt)) / 2             # curva sigmoide
cintas <- bind_rows(lapply(seq_len(nrow(fl)), function(i) {
  r <- fl[i, ]
  data.frame(id = i, o1 = as.numeric(r$o1),
             x = c(x1 + (x2 - x1) * tt, rev(x1 + (x2 - x1) * tt)),
             y = c(r$y1min + (r$y2min - r$y1min) * s, rev(r$y1max + (r$y2max - r$y1max) * s)))
})) |>
  mutate(cat = factor(cats[o1], cats))

# Barras de cada ola
barras <- bind_rows(
  w |> count(o = o1) |> mutate(x = 1),
  w |> count(o = o2) |> mutate(x = 2)
) |>
  group_by(x) |>
  mutate(p = 100 * n / sum(n), ymax = cumsum(p), ymin = ymax - p) |>
  ungroup() |>
  mutate(cat = factor(cats[o], cats),
         txt = ifelse(cat %in% c("Muy en desacuerdo", "Muy de acuerdo"), "white", "grey15"))

ggplot() +
  geom_polygon(data = cintas, aes(x = x, y = y, group = id, fill = cat), alpha = 0.45, colour = NA) +
  geom_rect(data = barras, aes(xmin = x - bw / 2, xmax = x + bw / 2, ymin = ymin, ymax = ymax, fill = cat),
            colour = "white", linewidth = 0.6) +
  geom_text(data = filter(barras, p >= 4), aes(x = x, y = (ymin + ymax) / 2, label = paste0(f1(p), "%"), colour = txt),
            size = 3.3) +
  scale_fill_manual(values = pal_p19, breaks = cats, name = NULL) +
  scale_colour_identity() +
  scale_x_continuous(breaks = 1:2, labels = c("Ola 1 (2023-2024)", "Ola 2 (2024)"), expand = expansion(add = 0.25)) +
  scale_y_continuous(breaks = seq(0, 100, 25), labels = function(x) paste0(x, "%"), expand = expansion(mult = 0.01)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 11) +
  theme(legend.position = "top",
        panel.grid.major.x = element_blank(),
        panel.grid.minor = element_blank(),
        panel.grid.major.y = element_line(colour = "grey92"))
```

### Relación con las creencias meritocráticas

```{r}
#| label: setup-correlaciones
#| include: false
items <- c(p1_9 = "Igualdad de oportunidades",
           p1_1 = "Percepción mérito: esfuerzo",
           p1_2 = "Percepción mérito: inteligencia",
           p1_3 = "Percepción privilegio: padres ricos",
           p1_4 = "Percepción privilegio: contactos",
           p1_5 = "Preferencia mérito: esfuerzo",
           p1_6 = "Preferencia mérito: talento",
           p1_7 = "Aceptación privilegio: padres ricos",
           p1_8 = "Aceptación privilegio: contactos")

x_w1 <- datos_io |>
  filter(ola == 1) |>
  select(all_of(names(items))) |>
  mutate(across(everything(), as.numeric))

rho <- psych::polychoric(x_w1)$rho
n_par <- crossprod(!is.na(as.matrix(x_w1)))
r <- function(a, b) f1(rho[a, b], 2)
```

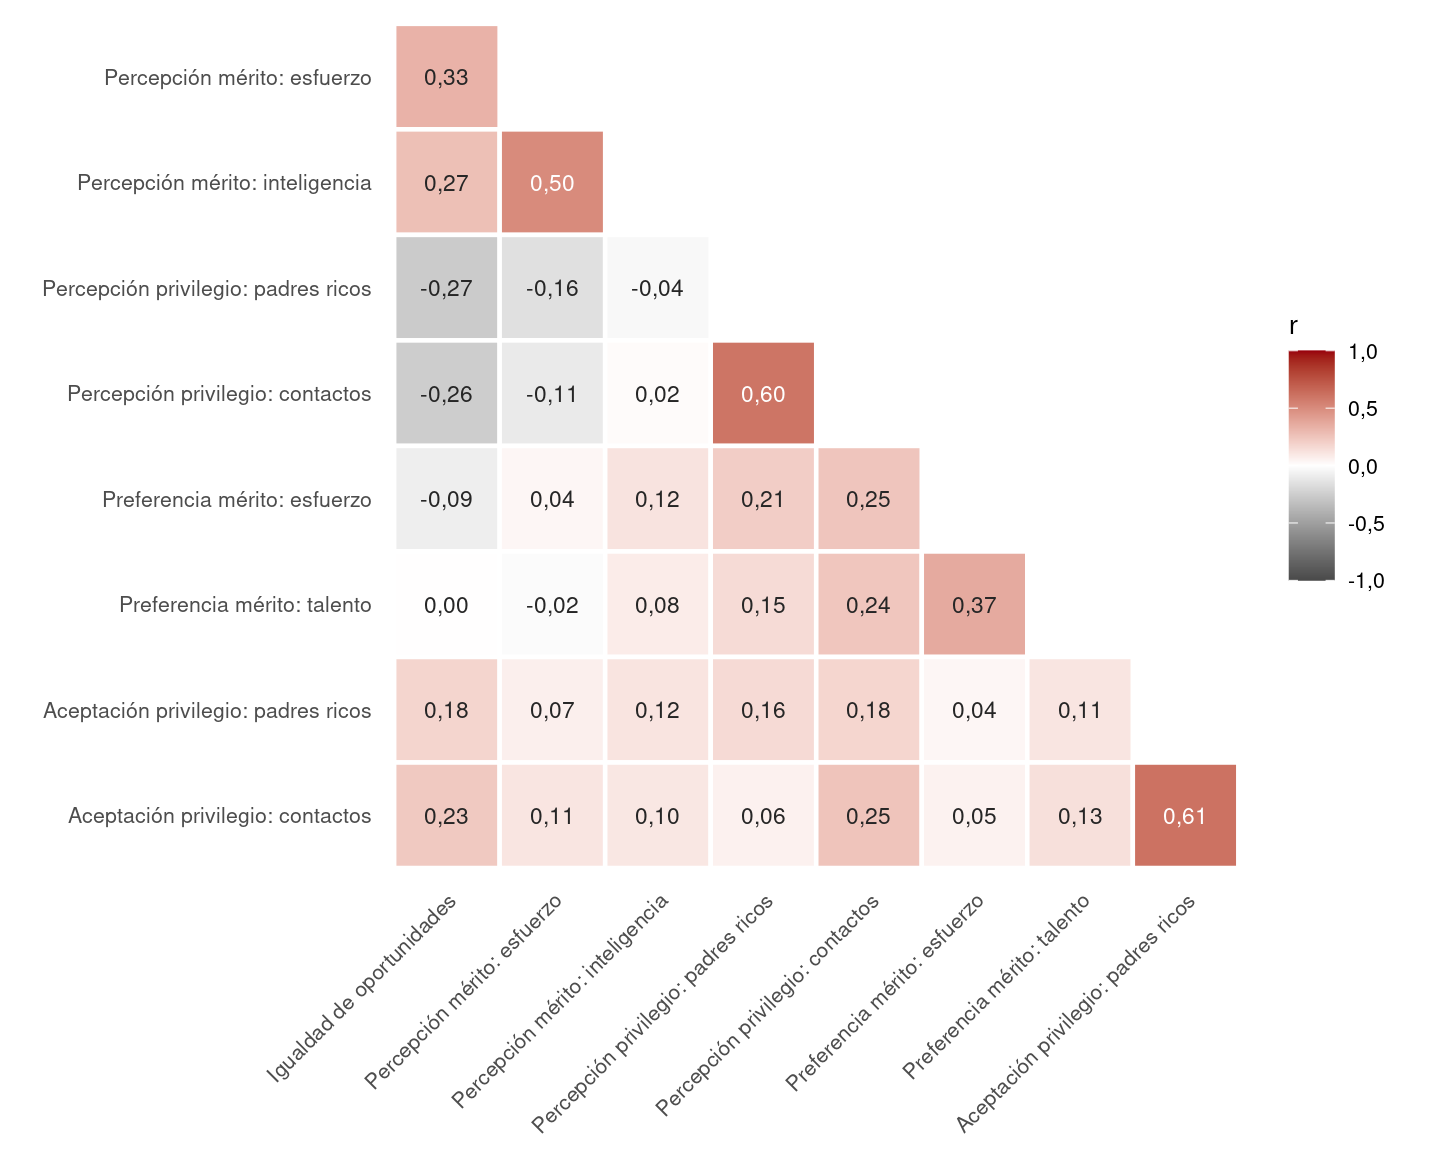
Para evaluar si los estudiantes distinguen la igualdad de oportunidades de las creencias meritocráticas, la @fig-correlaciones presenta las correlaciones policóricas, adecuadas para ítems ordinales, entre la variable dependiente y los ocho ítems de la escala de percepciones y preferencias sobre la meritocracia, en la primera ola (n entre `r min(n_par)` y `r max(n_par)` según el par de ítems).

```{r}
#| label: fig-correlaciones
#| fig-cap: "Correlaciones policóricas entre la percepción de igualdad de oportunidades y los ítems de la escala de percepciones y preferencias sobre la meritocracia. Ola 1. Datos perdidos tratados por pares (pairwise)."
#| echo: false
#| fig-width: 7.5
#| fig-height: 6
lab <- unname(items)
cor_df <- as.data.frame(as.table(rho)) |>
  setNames(c("v1", "v2", "r")) |>
  mutate(i = match(v1, names(items)), j = match(v2, names(items))) |>
  filter(i > j) |>
  mutate(f = factor(lab[i], rev(lab)), c = factor(lab[j], lab),
         txt = ifelse(abs(r) >= 0.45, "white", "grey15"))

ggplot(cor_df, aes(x = c, y = f, fill = r)) +
  geom_tile(colour = "white", linewidth = 0.8) +
  geom_text(aes(label = f1(r, 2), colour = txt), size = 3) +
  scale_fill_gradient2(low = "#4A4A4A", mid = "white", high = "#99000D", midpoint = 0,
                       limits = c(-1, 1), breaks = seq(-1, 1, 0.5),
                       labels = function(x) f1(x, 1), name = "r") +
  scale_colour_identity() +
  scale_x_discrete(position = "bottom") +
  labs(x = NULL, y = NULL) +
  coord_fixed() +
  theme_minimal(base_size = 10) +
  theme(axis.text.x = element_text(angle = 45, hjust = 1),
        panel.grid = element_blank(),
        legend.position = "right")
```

Las correlaciones de la igualdad de oportunidades con los demás ítems son, en general, bajas o moderadas, y ninguna se acerca a la unidad. Las más altas corresponden a la percepción de meritocracia: la igualdad de oportunidades se asocia positivamente con percibir que en Chile se recompensa el esfuerzo (r = `r r("p1_9", "p1_1")`) y la inteligencia (r = `r r("p1_9", "p1_2")`). Estas correlaciones son menores que la que existe entre esos dos ítems entre sí (r = `r r("p1_1", "p1_2")`), lo que indica que la percepción de igualdad de oportunidades no es una medida más de la percepción de meritocracia, sino una creencia relacionada pero distinta, como sostiene el marco conceptual.

Las asociaciones con las dimensiones de privilegio siguen la dirección esperada en las hipótesis. La percepción de privilegio se relaciona negativamente con la igualdad de oportunidades (r = `r r("p1_9", "p1_3")` para los padres ricos y `r r("p1_9", "p1_4")` para los contactos), mientras que la aceptación del privilegio se relaciona positivamente (r = `r r("p1_9", "p1_7")` y `r r("p1_9", "p1_8")`). La preferencia meritocrática, en cambio, prácticamente no se asocia con la igualdad de oportunidades (r = `r r("p1_9", "p1_5")` y `r r("p1_9", "p1_6")`).

La matriz reproduce, además, la estructura de la escala de meritocracia: los dos ítems de cada dimensión se correlacionan más entre sí (entre `r f1(min(rho["p1_5", "p1_6"], rho["p1_1", "p1_2"], rho["p1_3", "p1_4"], rho["p1_7", "p1_8"]), 2)` y `r f1(max(rho["p1_5", "p1_6"], rho["p1_1", "p1_2"], rho["p1_3", "p1_4"], rho["p1_7", "p1_8"]), 2)`) que con los de otras dimensiones, lo que es consistente con la estructura de cuatro factores validada en estos datos [@laffert_changes]. La percepción de meritocracia y la de privilegio se relacionan de forma débil y mayormente negativa, lo que muestra que los estudiantes no las tratan como polos opuestos de una misma creencia. Las correlaciones entre los ítems de cada dimensión son, además, similares a las que se desprenden del análisis factorial confirmatorio que Laffert et al. [-@laffert_changes] estimaron con estos mismos datos.

## Efecto de la información sobre el acceso a la universidad

```{r}
#| label: setup-experimento
#| include: false
library(ordinal)

exp1 <- datos_io |>
  filter(ola == 1) |>
  mutate(across(c(trat, comprende, mujer_otro, extranjero, cohorte_media, id_escuela, p1_9), as.numeric),
         grupo = factor(trat, 0:1, c("Control", "Tratamiento")))
n_grupo <- table(exp1$grupo)

# Balance: porcentajes por grupo y prueba chi-cuadrado
pchi <- function(v) chisq.test(table(exp1$trat, exp1[[v]]))$p.value
bal <- exp1 |>
  group_by(grupo) |>
  summarise(mujer = 100 * mean(mujer_otro, na.rm = TRUE),
            extranjero = 100 * mean(extranjero, na.rm = TRUE),
            media = 100 * mean(cohorte_media, na.rm = TRUE))
p_bal <- c(mujer = pchi("mujer_otro"), extranjero = pchi("extranjero"),
           media = pchi("cohorte_media"), escuela = pchi("id_escuela"))

# Comprensión de la información
comp <- exp1 |> group_by(grupo) |> summarise(c = 100 * mean(comprende, na.rm = TRUE))
cp <- function(g) comp$c[comp$grupo == g]

# Regresión logística ordinal con efectos fijos de estrato (escuela x cohorte)
d_exp <- exp1 |> filter(!is.na(p1_9_ord))
m1 <- clm(p1_9_ord ~ trat + estrato, data = d_exp, link = "logit")
b1 <- coef(summary(m1))["trat", ]
or1 <- exp(b1[["Estimate"]])
ci1 <- exp(confint.default(m1)["trat", ])
p1 <- b1[["Pr(>|z|)"]]

pval <- function(p) ifelse(p < 0.001, "< 0,001", paste("=", f1(p, 3)))
acu_g <- function(t) 100 * mean(d_exp$p1_9[d_exp$trat == t] >= 3)
```

El experimento de la primera ola permite estimar el efecto causal de la información sobre el acceso a la universidad (H4). De los `r sum(n_grupo)` estudiantes de la primera ola, `r n_grupo[["Tratamiento"]]` fueron asignados al grupo tratamiento y `r n_grupo[["Control"]]` al grupo control.

**Balance.** Para verificar que la asignación aleatoria produjo grupos comparables, la @tbl-balance compara ambos grupos en características que no pueden ser afectadas por la información recibida, mediante pruebas chi-cuadrado. Las diferencias son pequeñas y ninguna es estadísticamente significativa.

```{r}
#| label: tbl-balance
#| tbl-cap: "Balance entre el grupo tratamiento y el grupo control. Porcentajes y valor p de la prueba chi-cuadrado. Ola 1."
#| echo: false
bc <- function(v, g) f1(bal[[v]][bal$grupo == g])
tibble(
  Característica = c("Mujer u otro género (%)", "Nacido/a fuera de Chile (%)", "Cohorte de media (%)", "Establecimiento"),
  Control = c(bc("mujer", "Control"), bc("extranjero", "Control"), bc("media", "Control"), "—"),
  Tratamiento = c(bc("mujer", "Tratamiento"), bc("extranjero", "Tratamiento"), bc("media", "Tratamiento"), "—"),
  p = f1(c(p_bal[["mujer"]], p_bal[["extranjero"]], p_bal[["media"]], p_bal[["escuela"]]), 3)
) |>
  kable(align = c("l", "r", "r", "r"))
```

**Comprensión de la información.** La proporción de estudiantes que responde correctamente la pregunta de verificación es similar en ambos grupos: `r f1(cp("Tratamiento"))`% en el grupo tratamiento y `r f1(cp("Control"))`% en el grupo control.

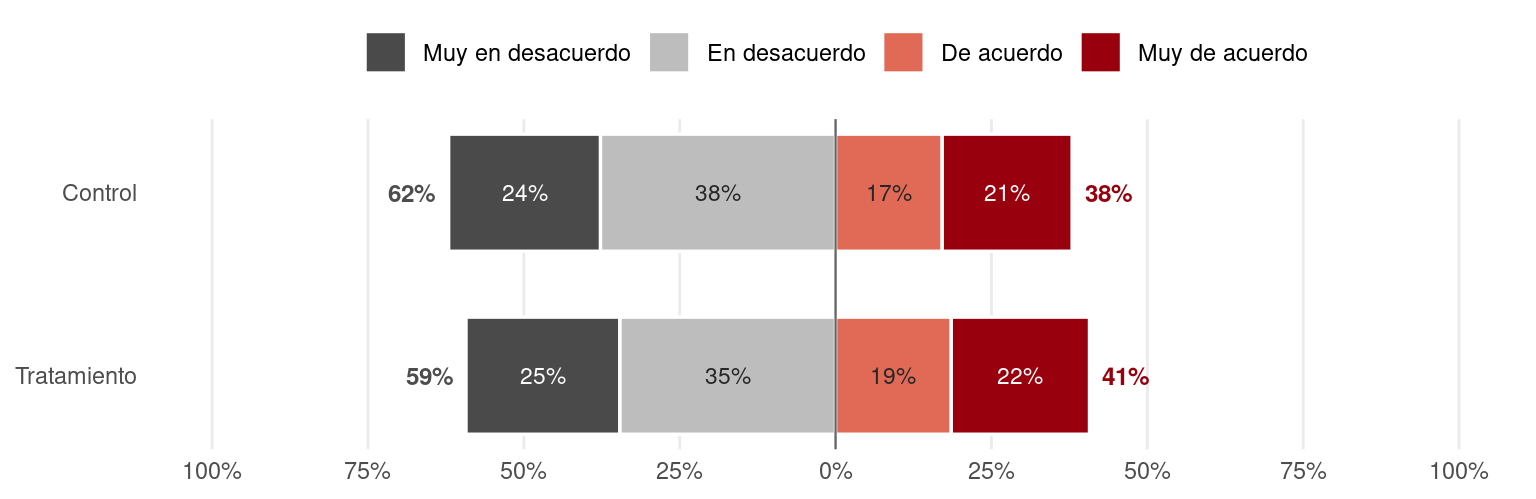
**Efecto de la información.** La @fig-experimento muestra la distribución de la percepción de igualdad de oportunidades en cada grupo. Las distribuciones son muy similares: el `r f1(acu_g(1))`% del grupo tratamiento está de acuerdo o muy de acuerdo con que todas las personas tienen las mismas oportunidades, frente al `r f1(acu_g(0))`% del grupo control.

```{r}
#| label: fig-experimento
#| fig-cap: "Percepción de igualdad de oportunidades según grupo experimental. Porcentajes; a la izquierda, desacuerdo; a la derecha, acuerdo. Ola 1."
#| echo: false
#| fig-width: 8
#| fig-height: 2.6
ge <- d_exp |>
  count(grupo, p1_9_ord) |>
  group_by(grupo) |>
  mutate(pct = 100 * n / sum(n)) |>
  ungroup() |>
  select(-n) |>
  pivot_wider(names_from = p1_9_ord, values_from = pct, values_fill = 0) |>
  mutate(yy = as.numeric(factor(grupo, c("Tratamiento", "Control"))))

segs_e <- bind_rows(
  ge |> transmute(yy, cat = "En desacuerdo",     xmin = -`En desacuerdo`, xmax = 0),
  ge |> transmute(yy, cat = "Muy en desacuerdo", xmin = -`En desacuerdo` - `Muy en desacuerdo`, xmax = -`En desacuerdo`),
  ge |> transmute(yy, cat = "De acuerdo",        xmin = 0, xmax = `De acuerdo`),
  ge |> transmute(yy, cat = "Muy de acuerdo",    xmin = `De acuerdo`, xmax = `De acuerdo` + `Muy de acuerdo`)
) |>
  mutate(cat = factor(cat, cats), x = (xmin + xmax) / 2, w = xmax - xmin,
         txt = ifelse(cat %in% c("Muy en desacuerdo", "Muy de acuerdo"), "white", "grey15"))
tot_e <- ge |> transmute(yy, des = `Muy en desacuerdo` + `En desacuerdo`, acu = `De acuerdo` + `Muy de acuerdo`)

ggplot(segs_e) +
  geom_rect(aes(xmin = xmin, xmax = xmax, ymin = yy - 0.32, ymax = yy + 0.32, fill = cat),
            colour = "white", linewidth = 0.6) +
  geom_text(data = filter(segs_e, w >= 5), aes(x = x, y = yy, label = paste0(f1(w, 0), "%"), colour = txt), size = 3) +
  geom_text(data = tot_e, aes(x = -des - 2, y = yy, label = paste0(f1(des, 0), "%")),
            hjust = 1, size = 3.2, fontface = "bold", colour = "grey30") +
  geom_text(data = tot_e, aes(x = acu + 2, y = yy, label = paste0(f1(acu, 0), "%")),
            hjust = 0, size = 3.2, fontface = "bold", colour = "#99000D") +
  geom_vline(xintercept = 0, colour = "grey40", linewidth = 0.4) +
  scale_fill_manual(values = pal_p19, breaks = cats, name = NULL) +
  scale_colour_identity() +
  scale_x_continuous(limits = c(-100, 100), breaks = seq(-100, 100, 25), labels = function(x) paste0(abs(x), "%")) +
  scale_y_continuous(breaks = 1:2, labels = c("Tratamiento", "Control")) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 11) +
  theme(legend.position = "top",
        panel.grid.major.y = element_blank(),
        panel.grid.minor = element_blank(),
        panel.grid.major.x = element_line(colour = "grey92"))
```

Para estimar el efecto se utiliza el primer modelo (@eq-modelo1), una regresión logística ordinal de la percepción de igualdad de oportunidades sobre la asignación al tratamiento, con efectos fijos de cada cohorte dentro de cada escuela, que es el nivel en que se realizó el sorteo. El efecto de la información no es estadísticamente significativo (razón de odds = `r f1(or1, 2)`; IC 95%: `r f1(ci1[1], 2)`–`r f1(ci1[2], 2)`; p `r pval(p1)`; n = `r nobs(m1)`). Por tanto, los resultados no apoyan H4: no se encuentra evidencia de que recibir información sobre las diferencias de acceso a la universidad modifique la percepción de igualdad de oportunidades.